Как посмотреть страницу глазами поисковика
Как выгрузить сырой HTML страниц от имени Googlebot или браузера в ZIP, сравнить его с браузером и найти текст и ссылки, которые появляются только после JavaScript.
Для чего. Браузер показывает страницу после выполнения всех скриптов, а сервер сначала отдаёт исходный HTML. Если важный текст, ссылки или разметка появляются только после JavaScript, робот, который скрипты не выполняет или выполняет с задержкой, может их не увидеть. Инструмент «Выгрузка HTML» заходит на ваши адреса с сервера платформы с User-Agent Googlebot или обычного браузера и отдаёт сырой ответ сервера одним ZIP-архивом. Скрипты при этом не выполняются: вы видите ровно то, что отдал сервер. Описание на сайте: HTML-экспорт. Содержимое архива и лимиты: Выгрузка HTML: что внутри архива и лимиты.
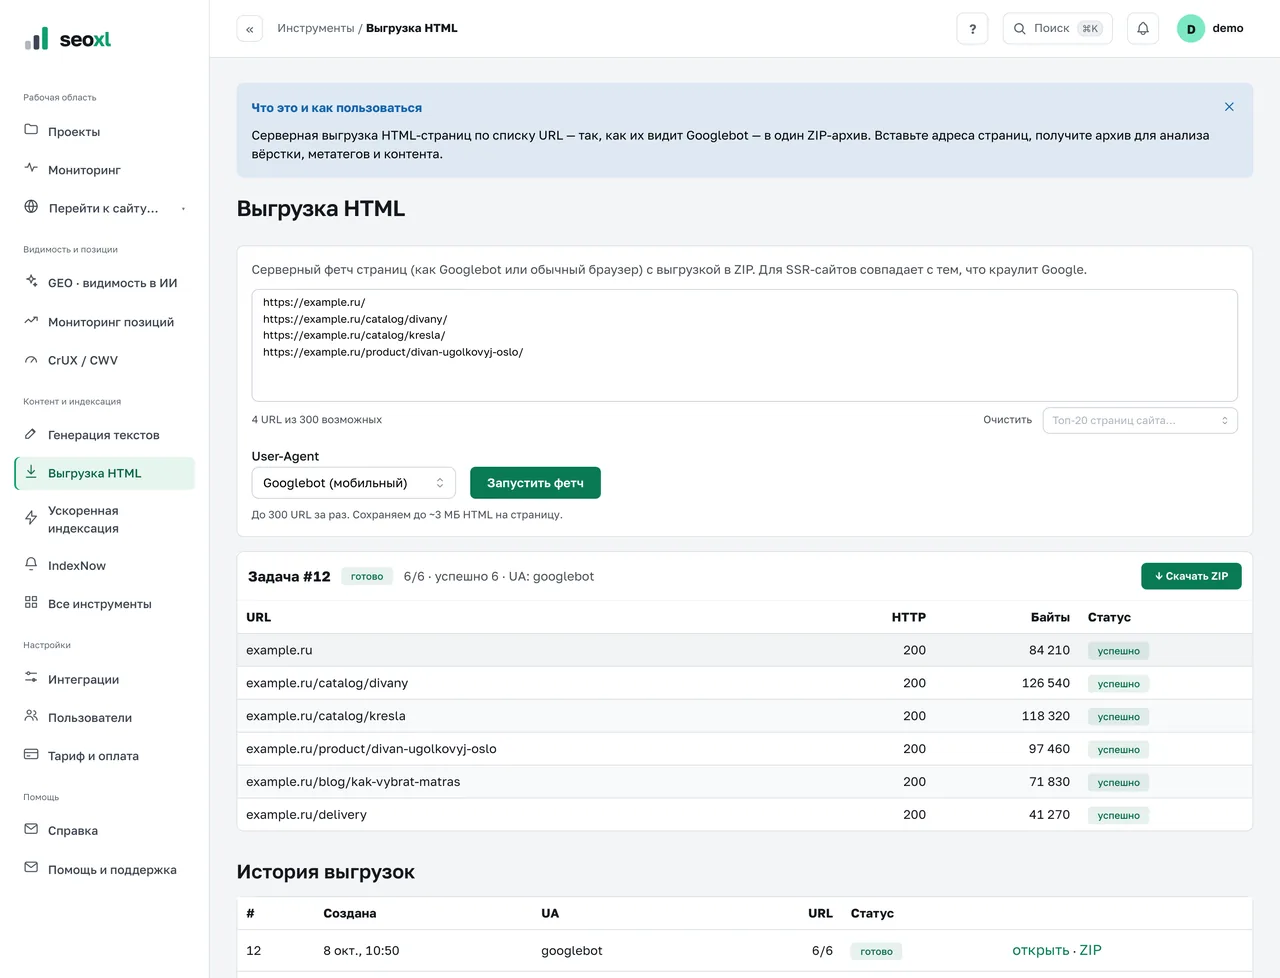
Выгрузка HTML: список URL, выбор User-Agent и результат с кодами ответа.
Шаги
- Откройте инструмент. Раздел «Выгрузка HTML».
- Вставьте адреса. Один адрес в строке. Адрес без
https://дополнится сам, дубли и некорректные строки отбрасываются. На Free доступно до 50 адресов за раз, на Старте и выше до 300. Начните с типовых страниц: карточка товара, категория, статья. - Выберите «User-Agent». «Googlebot (мобильный)» запрашивает страницу как робот, «Обычный браузер» как посетитель.
- Нажмите «Запустить фетч». Задача идёт на сервере: страницу можно закрыть и вернуться позже. В таблице у каждого адреса появятся «HTTP», «Байты» и статус «успешно» или причина ошибки.
- Скачайте архив. Когда задача завершится, нажмите «↓ Скачать ZIP». Прошлые выгрузки лежат ниже в «Истории выгрузок», кнопка «ZIP» скачивает архив, «открыть» возвращает таблицу.
- Сравните с браузером. Откройте файл из папки
html/в текстовом редакторе. Рядом откройте ту же страницу в браузере, откройте исходный код страницы через контекстное меню или сочетание Ctrl+U (это тоже исходный HTML) и сравните его с вкладкой «Элементы» в инструментах разработчика (это уже страница после скриптов). - Проверьте
manifest.csv. В нём по каждому адресу код ответа, итоговый адрес после редиректов, размер и ошибка. Выгрузите одни и те же страницы в обоих режимах: если роботу сервер отвечает другим кодом, редиректом или заметно меньшим размером, разбирайтесь с настройками сайта.
Что искать в HTML
- Основной текст. Есть ли в файле описания, характеристики, статья. Если вместо них пустой контейнер вроде
<div id="root"></div>, контент рисует JavaScript. - Внутренние ссылки. Видны ли ссылки обычными тегами
<a href>. Переходы только на скриптах робот может не пройти. - Заголовки и разметка. На месте ли
<title>, H1, canonical и микроразметка. - Что делать, если этого нет. Попросите разработчиков отдавать основной контент в ответе сервера (SSR или предварительный рендеринг), а переходы делать обычными ссылками
<a href>. Если всё на месте, проверьте другие шаблоны: проблема часто сидит в отдельном типе страниц. - Сколько контента теряется без скриптов, считает и аудит сайта: вкладка «Рендеринг».
Если не получилось
- «На вашем тарифе до 50 URL за одну выгрузку». Это тариф Free: разбейте список или перейдите на Старт.
- «Дневной лимит выгрузок HTML исчерпан». Счётчик обнуляется на следующие сутки по UTC. Остаток виден рядом с кнопкой.
- У всех страниц статус «ошибка». Сайт может блокировать запросы с чужих адресов или по User-Agent Googlebot. Попробуйте режим «Обычный браузер».
- Страница в ZIP почти пустая. Для сайта, который рисует контент в браузере, это нормальный результат: так он и выглядит без скриптов.
- Адрес отклонён. Адреса на локальные и приватные сети не принимаются.
- Остальное: Выгрузка HTML: что внутри архива и лимиты.
Что дальше
Читайте также
Ещё в разделе «Инструменты»
- Каталог инструментов и суточные лимиты
- Как читать аудит сайта
- Аудит сайта: параметры, отчёт и лимиты
- Как работает GEO: видимость бренда в нейросетях
- GEO: мастер, расписание и лимиты
- Ускоренная индексация через Google Indexing API
- CrUX и Core Web Vitals
- История запусков
- Как настроить IndexNow
- IndexNow: ключ, карта сайта и фильтры
- Проверка robots.txt и sitemap без регистрации
- Как страницу видит робот: проверка без регистрации
- Core Web Vitals любого сайта: проверка без регистрации
- Как генерировать тексты по таблице
- Генерация текстов: режимы, лимиты и ошибки
- Выгрузка HTML: что внутри архива и лимиты
- Как настроить мониторинг позиций в кабинете
Сверено с кабинетом: 8 октября 2026. Заметили расхождение с тем, что видите в интерфейсе? Напишите на support@tools.seoxl.ru.