Как увидеть страницу глазами поискового робота: noindex, canonical, редиректы и клоакинг
В браузере страница выглядит нормально, а в поиске её нет. Часто причина в том, что робот получает от сервера не то же самое: другой код, лишний редирект, noindex или пустой каркас без текста.
Коротко. Введите адрес страницы в бесплатную проверку: сервис откроет её три раза, как Googlebot, как YandexBot и как обычный браузер, и покажет код ответа, редиректы, title, canonical, noindex и расхождения между клиентами. Замечания с уровнем «Ошибка» исправляйте первыми.
Что именно показывает проверка
Проверка загружает один адрес тремя способами и сравнивает результаты. Для каждого клиента видно код ответа и время, итоговый адрес, title, h1, description, canonical, meta robots, X-Robots-Tag, число слов, типы разметки JSON-LD, закрыта ли страница в robots.txt, язык и размер ответа. Отдельно показана цепочка редиректов: каждый шаг с кодом, адресом и временем.
Регистрация не нужна, доступ к сайту и кабинетам поисковиков тоже. Проверяется одна страница, а не весь сайт.
Как запустить
- Откройте проверку «Как страницу видит поисковый робот».
- Вставьте полный адрес, например
https://example.ru/catalog/. Если не написатьhttps://, он подставится сам. - Нажмите «Проверить». Обычно это несколько секунд, на медленных сайтах до минуты.
- Прочитайте вердикт: «Всё в порядке», «Есть предупреждения» или «Есть ошибки». Под ним число ошибок, предупреждений и заметок.
- Просмотрите цепочку редиректов, карточки клиентов и сравнение, затем замечания: у каждого есть строка «Что делать».
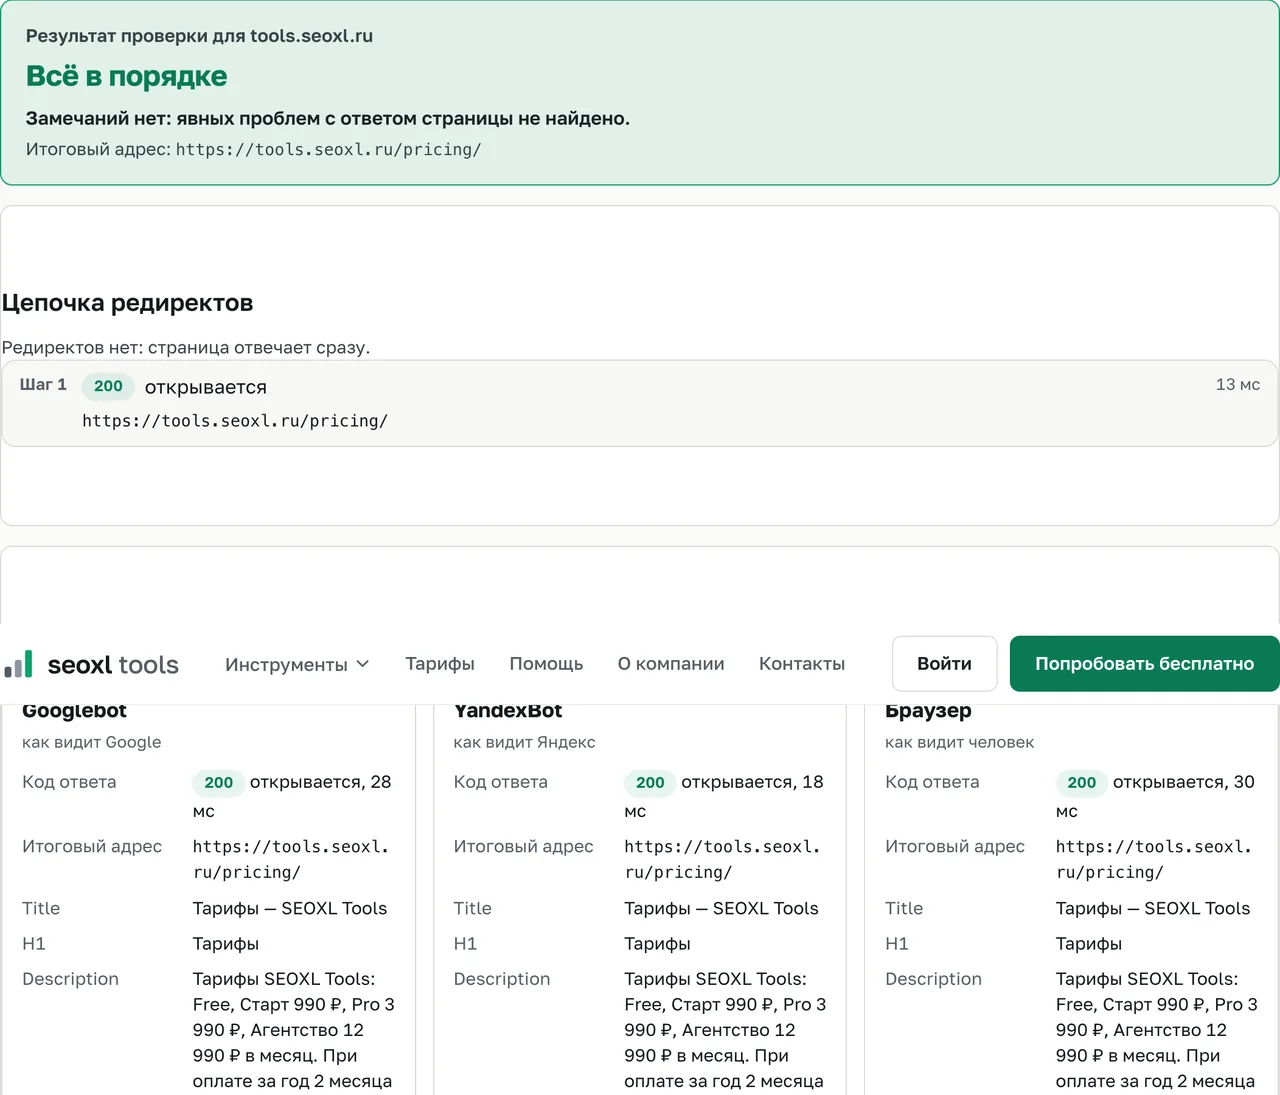
Результат для страницы нашего сайта: без редиректов, у всех трёх клиентов код 200 и одинаковые title и h1.
Что искать в результате
Код ответа и редиректы. Хорошо, когда переход один или их нет. Длинная цепочка и цикл подсвечены отдельно. Настройте один 301 сразу на итоговый адрес, а в ссылках и sitemap указывайте итоговый адрес. Редирект на http вместо https тоже попадёт в замечания.
Запреты на индексацию. Noindex может стоять в метатеге robots или в HTTP-заголовке X-Robots-Tag, и проверка показывает оба места. Типичная ситуация: запрет поставили на время разработки и забыли убрать при релизе. Если страница нужна в поиске, уберите noindex и запросите переобход.
Canonical. Если canonical указывает на другой адрес, поисковик считает эту страницу копией. Оставьте так для настоящего дубля, иначе пропишите canonical на саму страницу. Отсутствие тега тоже отмечается.
Текст в HTML. Проверка не исполняет JavaScript: она показывает ответ до работы скриптов. Если в теле только контейнер, появится замечание «Страница строится скриптом» (js_only_suspected). Отдавайте основной текст в HTML: серверный рендеринг, предрендер или статическая генерация. Что именно получает робот, можно скачать в HTML-экспорте.
Мягкая 404. Страница отвечает 200, но выглядит пустой или ошибочной (soft_404_suspected). Верните настоящий 404 или 410 либо наполните страницу.
Закрытие в robots.txt. Замечание blocked_by_robots значит, что правило не пускает робота. Какое именно, покажет проверка robots.txt и sitemap.
Три типичных сценария
Раздел пропал из выдачи после релиза. Проверка пишет «Ошибка» и «Noindex в мета-теге» (noindex_meta) или «Noindex в заголовке» (noindex_header). Скорее всего, запрет остался от тестового окружения. Уберите noindex в шаблоне или настройках сервера, затем запросите переобход через IndexNow или Search Console.
Страница открывается, но в индексе пустая. В карточках ботов мало слов, а в тексте замечаний «Страница строится скриптом». Поисковик получает каркас, а текст появляется только после скриптов. Нужен серверный рендеринг или предрендер, после правки число слов у ботов должно сравняться с браузером.
Ссылка ведёт через несколько переходов. В цепочке три шага: с http на https, потом на www, потом добавляется слэш, и проверка пишет «Длинная цепочка редиректов» (redirect_chain_long). Настройте один 301 на итоговый адрес и поправьте внутренние ссылки, чтобы они вели сразу на него.
В каждом случае после правки нажмите «Проверить» ещё раз и сравните число замечаний.
Как выглядит клоакинг и как его заметить
Клоакинг это когда роботам показывают одно содержимое, а людям другое. В блоке «Сравнение ботов и браузера» сервис проверяет, совпадают ли код ответа, итоговый адрес, заголовок и canonical, и считает, насколько отличается текст. Если текст отличается больше чем на 30%, страница помечается как подозрительная на клоакинг.
Не всякое расхождение это обман. Чаще всего ответы различаются из-за защиты от ботов, файрвола или геотаргетинга, которые реагируют на User-Agent. Но если содержимое зависит от User-Agent, поисковик увидит расхождение независимо от причины, поэтому её стоит найти и устранить (differs_by_agent).
Ограничения проверки
Запрос идёт с нашего сервера, а не с адреса настоящего Googlebot или YandexBot: мы лишь подставляем их User-Agent. Сайты, которые отличают ботов по IP, отдадут настоящим роботам другое, и здесь этого не видно. Кроме того, JavaScript не исполняется. Поэтому «Всё в порядке» это отсутствие проблем в этих проверках, а не гарантия индексации. Если все три клиента получили ошибку, а в браузере страница открывается, скорее всего, наш сервер блокирует защита от ботов: разрешите его запросы или проверьте страницу другим способом.
Что делать дальше
- Проверьте важные страницы: главную, категорию, карточку и статью. Для сайта целиком используйте аудит.
- Если замечаний нет, а страницы нет в индексе, пройдите чек-лист из статьи почему страница не в индексе.
- Исправили правило в robots.txt: как проверить robots.txt и sitemap.
- Чтобы узнавать о сбоях сразу, подключите сайт: раздел «Здоровье» проверяет важные страницы по расписанию. Разбор всех замечаний: справка. В глоссарии есть термин canonical.
Частые вопросы
Видит ли проверка JavaScript?
Нет, она показывает ответ до работы скриптов. Если текст появляется только после выполнения JavaScript, проверка предупредит, что страница строится скриптом.
Это настоящий Googlebot?
Нет. Запрос идёт с нашего сервера с User-Agent робота. Сайты, которые отличают ботов по IP, могут отдать настоящему роботу другое.
Что значит «Подозрение на клоакинг»?
Текст страницы для ботов и для браузера отличается больше чем на 30%. Проверьте защиту от ботов, геотаргетинг и подмену содержимого по User-Agent.
Можно ли проверить сразу весь сайт?
Нет, проверяется один адрес. Для сайта целиком используйте аудит в кабинете и проверку robots.txt.
Читайте также
- Почему страница не в индексе Google и Яндекса: причины и как проверить
- Как проверить robots.txt и sitemap: что значат замечания и что исправить
- Core Web Vitals: что значат LCP, INP и CLS и как смотреть реальные данные
Справка по теме
Разборы SEO и GEO выходят и в Telegram, в канале основателя платформы Алексея Дёмкина: @ademkin_seo.